LoRA 模型训练到底在做什么
很多人玩 Stable Diffusion 一段时间后都会碰到同一个问题:想画一个固定的人、固定的画风,或者某个特定的物件,可光靠提示词怎么调都差了点意思。这时候大家就会听到一个词——炼 LoRA。听上去挺玄乎,又是"炼丹"又是"训练",但说白了,LoRA 训练干的其实是一件很具体的事:教大模型认识一个它原本不太熟的东西。
它到底在"学"什么
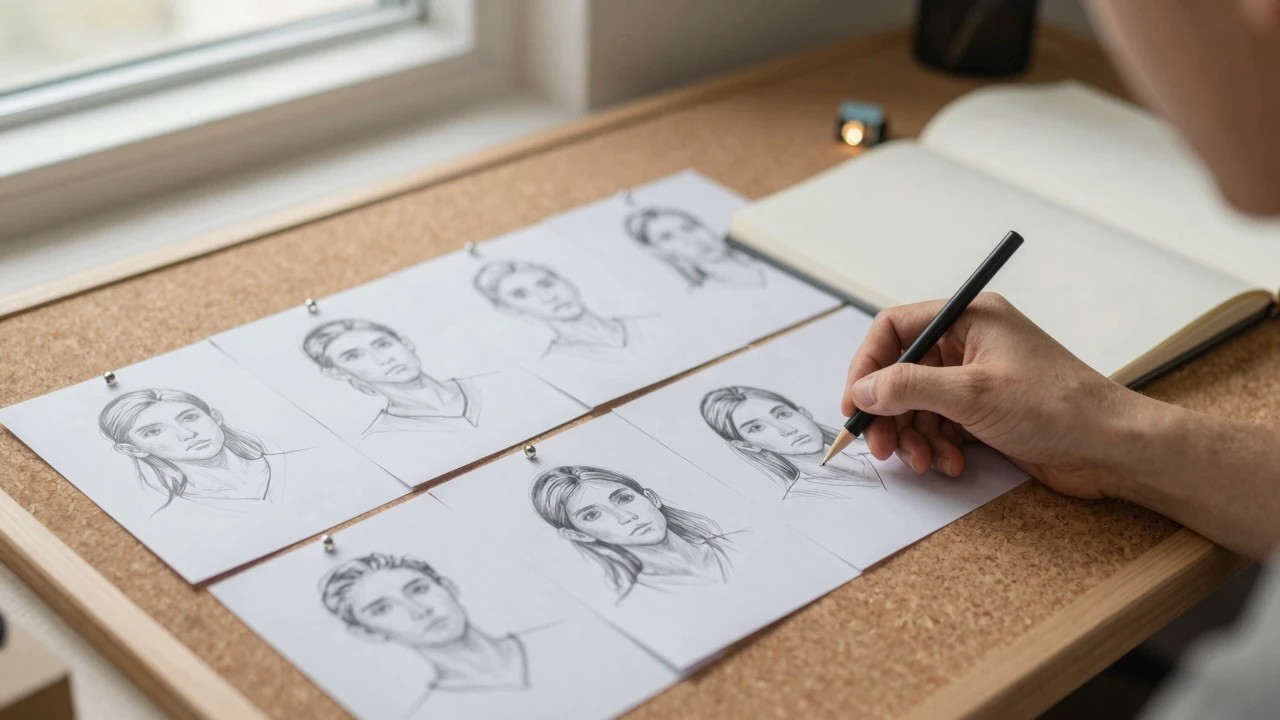
可以这么理解,大模型本身见识很广,什么风格都会一点,但它不认识"你指定的那个"。LoRA 训练就是拿一批图片喂给它,让它反复观察这些图里反复出现的特征,比如同一张脸、同一种笔触、同一类穿搭,然后把这些共性"记"下来。训练完得到的 LoRA 文件通常不大,使用时挂在大模型旁边当一个外挂补丁,大模型该会的照样会,只是多了你教给它的那部分记忆。这也是为什么大家更愿意练 LoRA,而不是重新训练一个大模型——成本低、文件小、换起来灵活。
为什么数据集是关键
从课程的编排也能看出门道:模型训练这块是先讲数据集准备,再讲参数配置,最后才轮到真正点下训练按钮和测试效果。这个顺序本身就说明问题。咱们普通人最容易误会的地方,是以为训练靠的是参数调得多花哨,其实喂进去的图片质量才是地基。图选得杂、标注得乱,后面参数再怎么拧也救不回来。想让模型学"人物统一",就得让它看到的全是同一个对象在不同角度、不同场景下的样子,它才能分清哪些是该记住的本体,哪些是可以随意变化的背景。
对想上手的人意味着什么
参数配置之所以分成上下两节来讲,也从侧面提醒大家,这一步确实有门槛,不是随便填几个数就能跑出好结果。好在课程里还单独留了一节"速成炼丹法",这其实是给怕麻烦的人准备的——先用相对简化的流程把第一个模型跑出来,看懂整个链路,再回头抠细节。对多数只想要一个能用的 LoRA 的人来说,这种思路反而更实在。
说到底,LoRA 训练不是什么神秘仪式,而是一套"准备素材、设定条件、让模型反复看、再验证好不好用"的流程。真正拉开差距的,往往不是谁的参数更花哨,而是谁更舍得在选图和测试上花时间。先跑通一个最简单的版本,比一上来就纠结每个数值要靠谱得多。
参与讨论
暂无评论,快来发表你的观点吧!